AI Seminar · 2026
World Models
이형민 · 서울과학기술대학교 전자공학과
Dreamer → Sora · Genie · Cosmos → Robotics frontier
Chapter 1
Dreamer Series
상상하는 기계 — 에이전트가 머릿속에 세계를 짓고, 그 안에서 꿈을 꾸며 행동을 배운다.
Agent와 Environment
World Model 이야기는 강화학습의 가장 기본 그림에서 출발한다.
에이전트는 행동을 하고, 환경은 다음 상태와 보상을 돌려준다.
목표는 누적 보상을 최대화하는 정책 를 찾는 것.
같은 조건부 확률은 겁먹지 말고, 신경망의 input → output 으로 읽으면 된다. 막대() 뒤가 입력, 앞이 출력.
조건 (∣ 뒤)
input
정책
신경망
결과 (∣ 앞)
output
용어를 실제 환경에 대응시켜 보자
얼음 호수를 건너 목표(G)에 도달. 구멍(H)은 피하면서.
환경이 ‘픽셀’로 주어진다면?
Frozen Lake의 상태는 칸 번호. 하지만 Doom·CarRacing은 화면 픽셀이다.
Doom — 관측이 곧 화면 픽셀. 손으로 ‘칸 번호’를 매길 수 없다. worldmodels.github.io
Frozen Lake
상태 = 격자 칸 번호. 사람이 직접 정의. 단순한 환경만 가능.
자연스러운 환경
고차원 픽셀은 손으로 불가. 데이터로 압축한 표현을 학습. 그게 VAE.
관측은 상태가 아니다 (, POMDP) — 압축된 latent 로 줄여야 한다.
환경을 ‘모델’로 가진다는 것
이제 픽셀을 압축했으니, 그 위에서 무엇을 할까. 여기서 두 갈래로 갈린다.
직접 부딪쳐 배운다
환경이 어떻게 작동하는지 전혀 분석하지 않는다. world를 파악하는 일도, 행동을 고르는 일도 agent 혼자다. 단서는 시행착오와 드문드문 오는 보상뿐. 안전하지도, 데이터 효율적이지도 않다.
한 몸이 두 일을
머릿속에서 미리 굴려본다
환경의 작동 방식(dynamics)은 따로 둔 전담 모델에 맡긴다 → agent는 그 이해 위에서 상상으로 계획하고 연습한다.
분업
어려운 절반을 떼어내 맡기고, agent는 그 이해 위에 올라탄다.
이 ‘머릿속 환경 모델’이 바로 World Model의 씨앗.
‘World를 이해한다’를 식으로 쓰면
말은 근사하지만, 학습시키려면 맞고 틀림을 셀 수 있는 목표여야 한다.
지금 상태에서 agent가 어떤 행동을 했을 때, 다음 상태가 어떻게 변하는지 예측하는 능력.
지금 상태 · 행동
input
작동 방식
신경망
다음 상태
output
식으로는 . 앞에서 익힌 읽는 법 그대로다. ‘다음을 맞혀라’는 목표 하나가, world의 작동 방식을 모델 안에 새긴다.
지금부터 읽을 논문
World Models
David Ha · Jürgen Schmidhuber · 2018 · worldmodels.github.io
앞에서 세운 그림을 처음으로 끝까지 조립해 보인 논문. world를 이해하는 일은 따로 맡기고, 그 모델이 다음을 예측하게 한다.
이제 세 부품을 하나씩 뜯어본다.
VAE — 관측을 latent로 압축
고차원 픽셀을 작은 벡터 z로. 보는 능력을 담당한다.
관측
latent 벡터
복원
어떻게 학습되는지는 Magic 로 넘긴다. 결론만 취하면, 관측이 latent 벡터로 잘 압축되고, 복원도 잘 된다.
Magic 학습 목표 — ELBO (다루지 않는다)
인터랙티브 데모
원논문 저자가 공개한 데모. 스크린샷을 z로 인코딩하고, 슬라이더로 복원이 어떻게 변하는지 본다.
Screenshot
z
Reconstruction
VizDoom 스크린샷으로 인코딩·복원을 직접 해볼 수 있다 — worldmodels.github.io
RNN으로 ‘다음’을 예측한다
과거를 hidden state h에 기억하며, 지금 행동의 결과로 올 다음 latent를 그린다.
가 과거를 압축해 다음 칸으로 전달 → 다음 latent 를 예측한다. 이 예측을 이어 붙이면 곧 ‘꿈’이 된다.
h를 받아 다음 행동을 결정한다
M이 다음을 예측하려고 만든 hidden state h를 입력으로, 행동은 작은 선형 하나로.
— 어려운 일(보기 V · 예측 M)은 이미 끝났으니, C는 작은 선형 하나면 충분하다.
세 부품을 합치면
보고(V) · 기억하며 예측하고(M) · 행동한다(C) — 이제 학습 차례.
World Model = V + M · Agent = C
어떻게 학습하는가
V·M·C를 한꺼번에 학습하지 않는다. 하나씩 얼리며(freeze) 차례로.
World Model vs Agent
V+M은 꿈을 ‘짓고’, C는 그 꿈 속에서 ‘산다’.
세상을 관찰해 이해하고, 그것을 바탕으로 다음을 예측한다 → ‘꿈’을 구성한다.
M이 구성해 놓은 꿈 속에서 시행착오를 겪으며 학습한다.
World Model은 외부 환경이 아니라, 에이전트가 내면에 학습한, 굴릴 수 있는 세계 모델 — 사람의 mental model처럼 머릿속에서 미래를 상상해 행동을 정한다.
C(Agent)는 환경이 아니라 World Model 내부의 state h를 직접 입력받는다. 그래서 world model은 에이전트 안에 있다.
한마디로 정의하면
World Model
세상을 관찰해 이해하고, 그것을 바탕으로
다음(행동의 결과)을 예측한다.
식으로는 — World Model과 Policy
가장 general한 두 식으로 본다.
과거 관측 + 행동 at → 다음을 예측한다.
과거 관측 → 다음 행동 at를 정한다.
둘이 맞물려 돈다. world model이 미래를 그리고, 그 안에서 policy가 행동을 정한다.
그리고 둘은 같은 내부 상태 ht를 공유한다 — 기억을 나눠 보며 함께 돈다.
예측을 어디에 쓸까 — 두 갈래
같은 world model이라도, 행동을 끌어내는 길은 다르다.
h를 받아 즉시 행동
미래가 압축된 를 정책 C에 넣어 바로 행동을 출력한다. (World Models · Dreamer)
여러 수를 둬보고 고른다
행동 후보 여럿을 M으로 굴려 예측 reward를 비교 → 가장 높은 행동을 선택 (planning).
World Model은 만드는 것만이 아니라, 어떻게 쓰느냐도 연구의 갈래다.
그럼, 게임을 그냥 돌리면 되지 않나?
Doom에서 다음에 무슨 일이 벌어질지 가장 정확히 아는 건, 누가 뭐래도 Doom 자신이다.
눌러보면 정답이 나온다
상태에서 행동을 실제로 눌러보면 다음 화면이 그대로 나온다. 오차 0, 학습도 필요 없다.
진짜 Doom
배워서 흉내 낸다
데이터로 학습한 근사. 오래 배워야 하고, 가끔 틀리기도 한다.
학습된 예측
그렇다면 — World Model은 결국 시뮬레이터인가?
반만 맞다
시뮬레이터 노릇을 하는 건 맞다. 그런데 그게 전부는 아니다.
게임 엔진이 주는 건 다음 화면뿐이다. 정작 우리가 쓰는 건 다음을 맞히도록 학습되며 생긴 내부 상태 ht, 그리고 그 예측을 수없이 굴려보는 수읽기다. 방금 본 두 갈래 그대로다.
게임 엔진에선 ht를 꺼낼 수 없다. 예측 능력을 빌려 쓰려면 신경망이어야 한다.
부엌도 도로도 공장도, real world엔 돌려볼 소프트웨어가 없다. 다음 chapter에서 다룰 세계가 바로 그렇다. 거기서는 world model이 월드 시뮬레이터 역할까지 떠맡는다.
시뮬레이터 역할도 한다. 그러나 본질은 미래를 예측하도록 학습된 표현을 쥐고 있다는 것. 그래서 반만 맞다.
같은 뼈대, 더 멀리
V·M·C와 ‘꿈속 학습’은 그대로 — 모델을 키우고 다듬어 더 어려운 세계로.
Dreamer 4 (2025) — 실제 게임을 한 번도 하지 않고, offline 데이터 + 상상 학습만으로 마인크래프트 다이아몬드. 영상: Google DeepMind · Dreamer 4
Chapter 2
세계를 생성하는 기계
World Model을 작은 agent 안에 두던 시절은 끝 — World Model 그 자체에 video diffusion이라는 뜻밖의 혁명이 일어난다.
비디오 생성을 넘어 — world simulator?
Video diffusion으로 비디오를 만드는 모델. 그런데 OpenAI의 주장은 그보다 컸다.
“단순히 비디오를 학습한 게 아니라 — 세상이 어떻게 생겼고, 시간에 따라 흘러가는지를 이해하고 보여주는 모델이다.” 물리 엔진 없이, 데이터만으로 world dynamics가 emergent하게 나타난다. 영상: OpenAI · Sora
그런데 — world model이라 할 수 있을까?
주장은 멋지지만, 결정적인 한 가지가 빠져 있다.
world model은 행동 at 를 입력으로 받아 미래를 만든다. 그런데 Sora엔 이 at가 없다 (텍스트 prompt뿐).
세계를 ‘보여준다’
텍스트 prompt → 그럴듯한 비디오. 세상의 모습과 시간 흐름을 생성한다.
action으로 ‘조종’ 못 한다
행동을 input으로 받아 world에 반영하지 못한다 — 보기만 할 뿐, 개입·제어 불가.
World Model은 굴려보며 행동을 정할 수 있어야 한다 (Ch1의 정의). 그래서 Sora는 엄밀히는 아직 world model이 아니다.
Action을 — label 없이
Sora가 못 한 ‘조종’을, Genie는 라벨 없는 영상만으로 해낸다.
text → video
멋진 영상이지만, 조종할 수 없다 (action 입력 없음).
라벨 없는 영상 → 조종 가능
게임 플레이 같은 unlabeled video만으로 action을 스스로 발명한다.
비결 — 영상만 보고 ‘무슨 행동이 일어났는지’를 모델이 스스로 알아낸다. (Latent Action Model)
VQ-VAE — latent를 ‘객관식’으로
VAE와 똑같은데, 중간 latent를 discrete하게. 정해진 codebook 후보 중 하나로 고른다.
연속 벡터
가장 가까운 것
discrete
무한한 연속 벡터를 K개 후보 중 하나로 — 표현이 ‘객관식’이 된다.
Magic loss엔 stop-gradient 트릭 (다루지 않는다)
action을 배우고, 그 action으로 조종한다
encoder가 프레임에서 action을 뽑고 decoder가 복원. 쓸 땐 같은 decoder에 action만 직접 넣는다.
복원이 진짜 과 같아지도록 학습 → at가 ‘변화(행동)’를 담는다. 라벨 없이.
encoder는 떼어내고, 원하는 action을 직접 넣어 세계를 조종한다.
action을 quantize — 정말 중요한 것만
latent action을 VQ로 묶으니(앞서 본 VQ-VAE), 자유도가 줄어 가장 의미있는 변화만 남는다.
연속 action
discrete action
자유도를 극단적으로 줄이면, 노이즈는 버려지고 ‘위·아래·점프’ 같은 의미있는 행동만 압축돼 담긴다.
나중에 8개를 하나씩 눌러보며 ‘이 action이 무슨 변화였는지’ 사람이 해석한다.
라벨 없이 배운 세계를, 직접 걷는다
2D 게임(Genie)에서 실시간 3D 세계(Genie 3)까지.
Genie 3 (2025) — 720p, 실시간으로 걸어다니는 일관된 세계. 영상: Google DeepMind · Genie
능력은 있지만, 그대로는 못 쓴다
JEPA · MAE · DINO — 강력한 vision 표현을 품었지만, 특정 task엔 ‘head’를 붙여야 한다.
pre-train으로 표현 능력을 얻고(고정), head만 붙여 학습하면 강력한 classifier. (head만, 또는 전체 fine-tune)
Cosmos — World Foundation Model
Sora처럼 강력한 video frame prediction. 거기에 상황별 ‘action control head’를 붙여 쓴다.
방금 본 foundation model처럼, pre-train된 video 예측 능력에 action을 입력으로 넣는 action control head를 붙여 로봇·자율주행 각 task로. → 그래서 World Foundation Model.
Cosmos를 — 로봇 전용 World Model로
방금 본 Cosmos를 백본으로, 44k시간 human video로 학습한 generalist 로봇 world model(시뮬레이터).
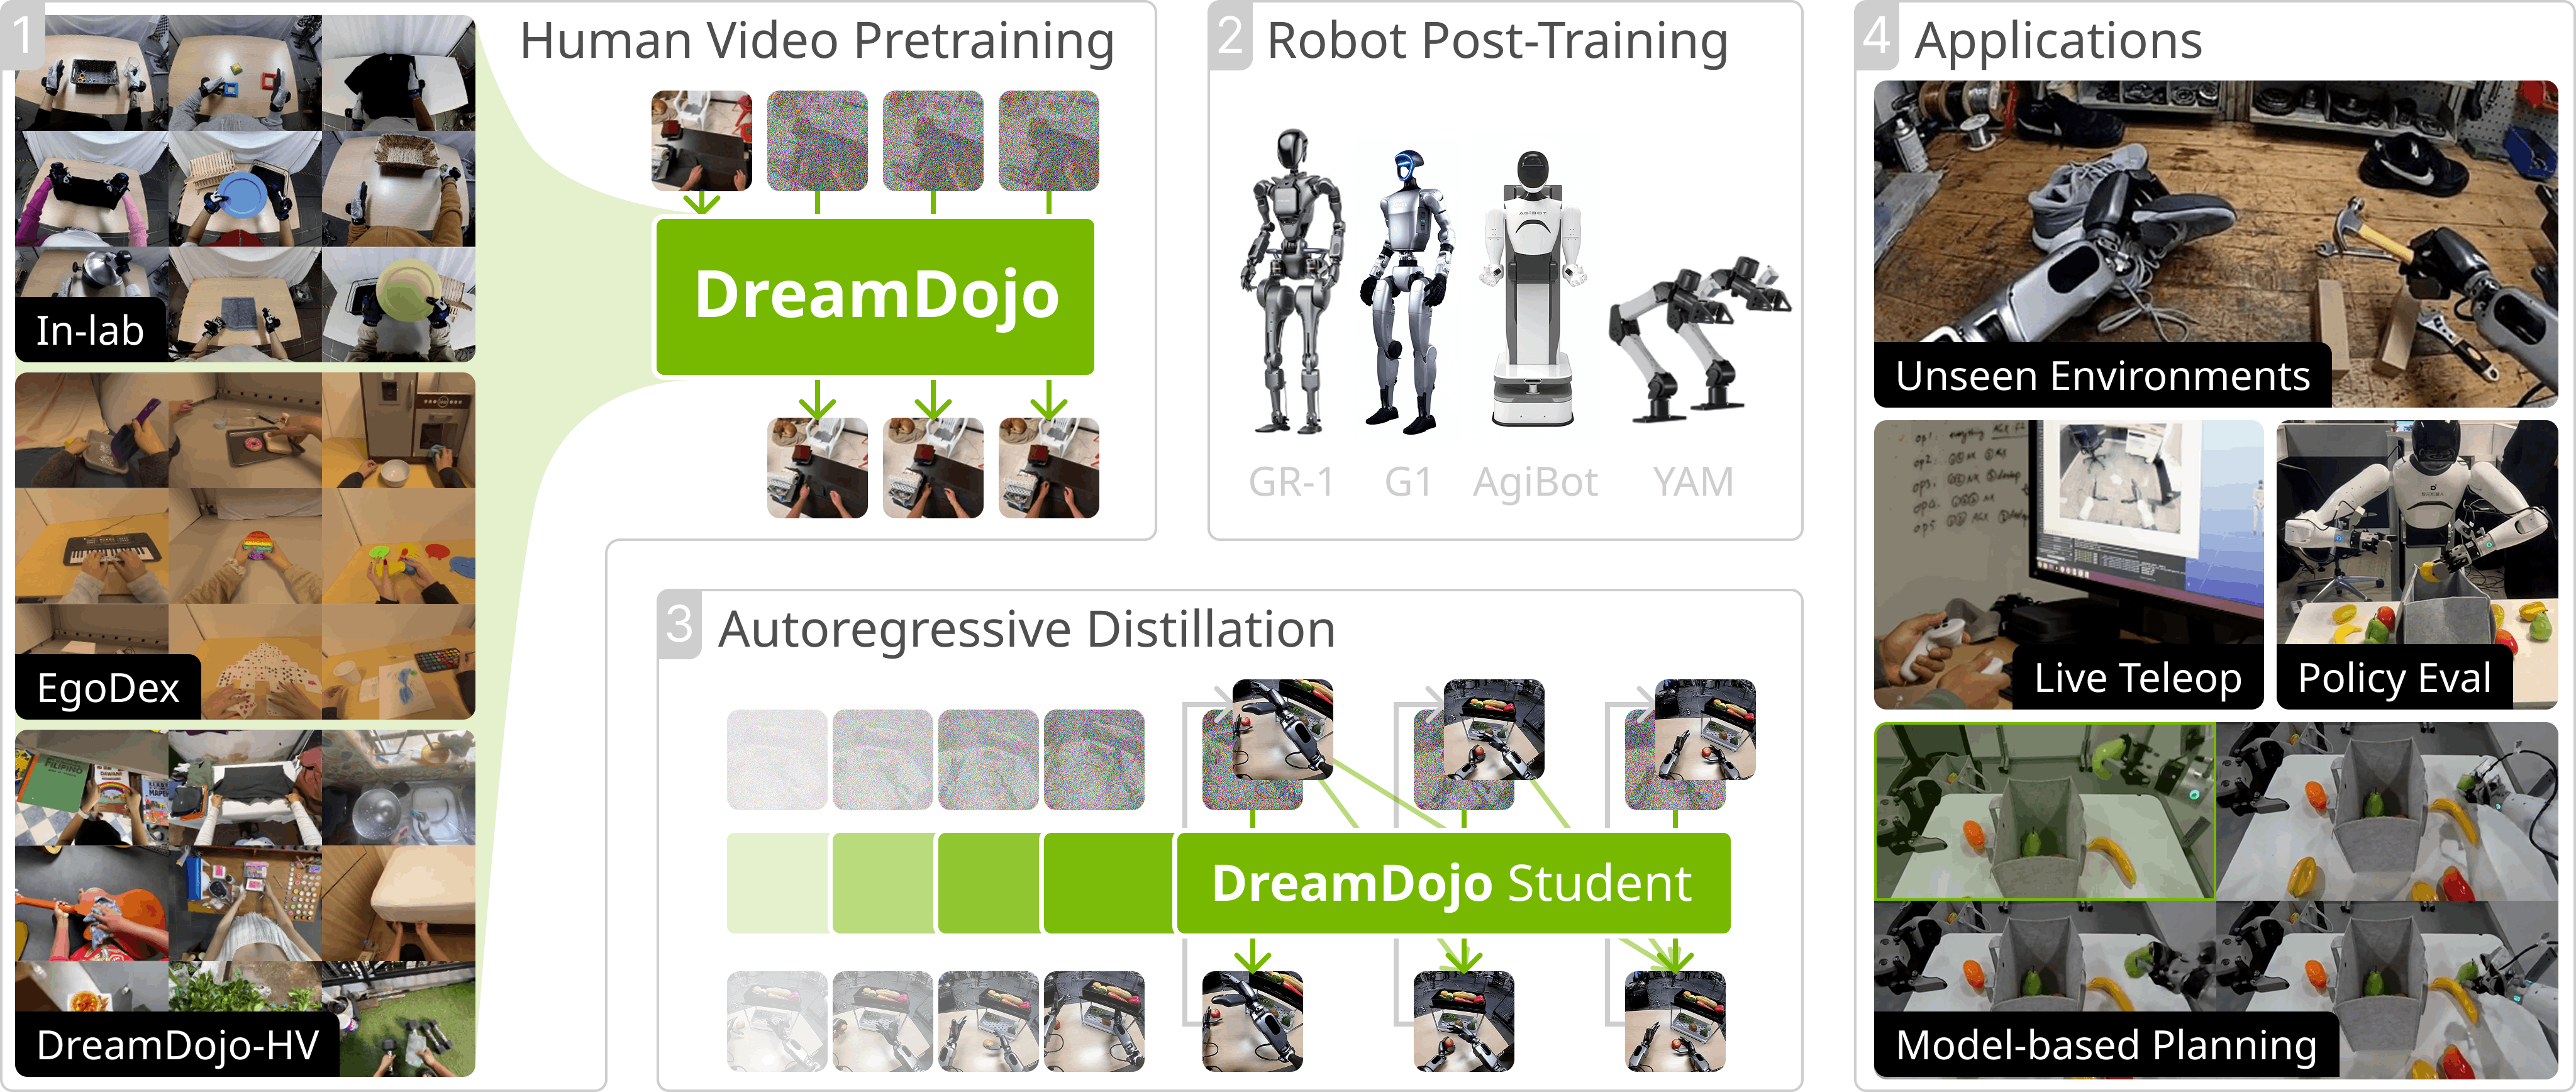
action을 입력(= 로봇 관절 데이터)으로 받아 미래를 예측한다 — Ch1의 world model 정의 그대로. 라벨 없는 human video는 Genie의 latent action으로 메운다. 그림: DreamDojo (NVIDIA GEAR, 2026)
Video World Model에 action을 더하는 두 가지 길
video prediction은 강력하지만, 그 자체엔 action이 없다. 현재 크게 두 갈래로 넣는다.
VAE처럼 latent space를 잘 설계해, action이 비디오에서 스스로 뽑히게 만든다. 뽑힌 latent action을 역으로 해석해 조종에 쓴다.
비디오와 시간적으로 sync된 실제 action label(예: 로봇 관절 데이터)로 supervised 학습. 직접적이고 정밀하다.
DreamDojo는 둘 다 쓴다 — 라벨 없는 human video엔 LAM, 실제 로봇엔 supervised label.
로봇 도메인의, 또 하나의 Foundation Model
Cosmos는 모든 것을 담지만, DreamDojo는 로봇으로 좁힌다. 그러나 닫지는 않는다.
세상 전부를 담는다
인간·게임·로봇 — 거의 모든 영상을 학습한다. 넓지만, 특정 로봇을 관절 수준으로 정밀 제어하진 않는다.
좁히되, 비워둔다
로봇으로 한정해 관절 데이터로 정밀 제어를 배운다. 그런데 action vector에 empty dim을 남겨, 다른 로봇이 들어올 공간을 비워둔다.
그래서 단일 로봇 모델이 아니라, 로봇 도메인의 작은 Foundation Model.
Ch1의 ‘머릿속 시뮬레이터’가 Ch2의 video 생성을 만나, 실제 로봇 관절 위에서 굴러간다.
로봇의 꿈 속은, 이렇다
DreamDojo가 상상한 미래 — action을 주면 세계가 그에 맞춰 펼쳐진다.
실제 로봇이 아니라, world model이 그려낸 ‘꿈’ 속 장면. 그 안에서 정책을 평가하고 계획한다. 영상: DreamDojo (NVIDIA GEAR, 2026) · dreamdojo-world.github.io
Video Generation이 최선일까?
지금까지 본 video diffusion world model. 그런데 치명적 약점이 하나 있다: world consistency.
① 왼쪽을 본다
② 고개를 돌린다
③ 집이 달라졌다 ❓
①과 ③은 같아야 하는데, video gen은 그런 보장이 없다.
video gen은 사실 implicit world model — 세상이 모델 weights에 저장돼 있고, 우린 매 순간 그것을 decoding해서 볼 뿐, 명시적으로 유지되는(persistent) world state가 없다. 그래서 장기·공간적 일관성(long-term spatial consistency)이 보장되지 않는다.
마인크래프트에서 네더 가는 법
정석은 분명한 ‘규칙’이 있다. 흑요석으로 차원문을 만들고, 통과해야 한다.
흑요석 블록
차원문 · 점화 🔥
네더 도착
명확한 규칙 — 흑요석 차원문을 통과해야만 네더에 갈 수 있다.
‘용암 텍스처’로 네더에 가기
AI 마인크래프트엔 진짜 차원문 규칙이 없다 — 그럴듯한 다음 프레임을 그릴 뿐.
네더엔 용암이 가득하다는 사실을 역이용한다. 화면을 용암처럼 만들면, 모델이 “여긴 네더구나” 하고 네더를 그려버린다.
차원문 없이도 ‘분위기’만으로 차원이 바뀐다 — 유지되는 world state가 없다는 consistency 약점을 그대로 보여주는 사례.
World Model을 3D로 — Explicit + Prior
세상을 명시적 3D 구조로 들고 있으면 — 어디서 보든, 돌아와도 그대로다.
3D Gaussian Splatting 같은 explicit representation은 geometry가 고정 → 공간 일관성이 보장된다. (= explicit world model, 강한 기하 prior) 영상: 3D Gaussian Splatting (Kerbl et al., 2023)
Implicit + Data vs Explicit + Prior
AI 전반에서 반복되는 논쟁이 world model에서도 그대로 나타난다.
데이터로 세상을 ‘암묵적’으로
장점비디오 데이터가 풍부 → 잘 확장되고, 다양한 세상을 담는다.
약점consistency 보장 X — persistent state가 없다.
구조를 ‘명시적’으로
장점명시적 geometry → consistency가 보장된다.
약점interaction이 어렵다 — world가 action에 따라 변하는 걸 직접 구현·학습하기 힘들고, 4D 데이터는 희소하다.
한쪽은 데이터가, 다른 쪽은 구조가 무기 — 둘 다 포기할 수 없다.
Thank You
감사합니다
이형민 · 서울과학기술대학교 전자공학과
hyeongmin.lee@seoultech.ac.kr