Paper Seminar · RSS 2023
Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware
ALOHA (하드웨어) · ACT (학습 알고리즘)
Tony Z. Zhao · Vikash Kumar · Sergey Levine · Chelsea Finn (Stanford · UC Berkeley · Meta)
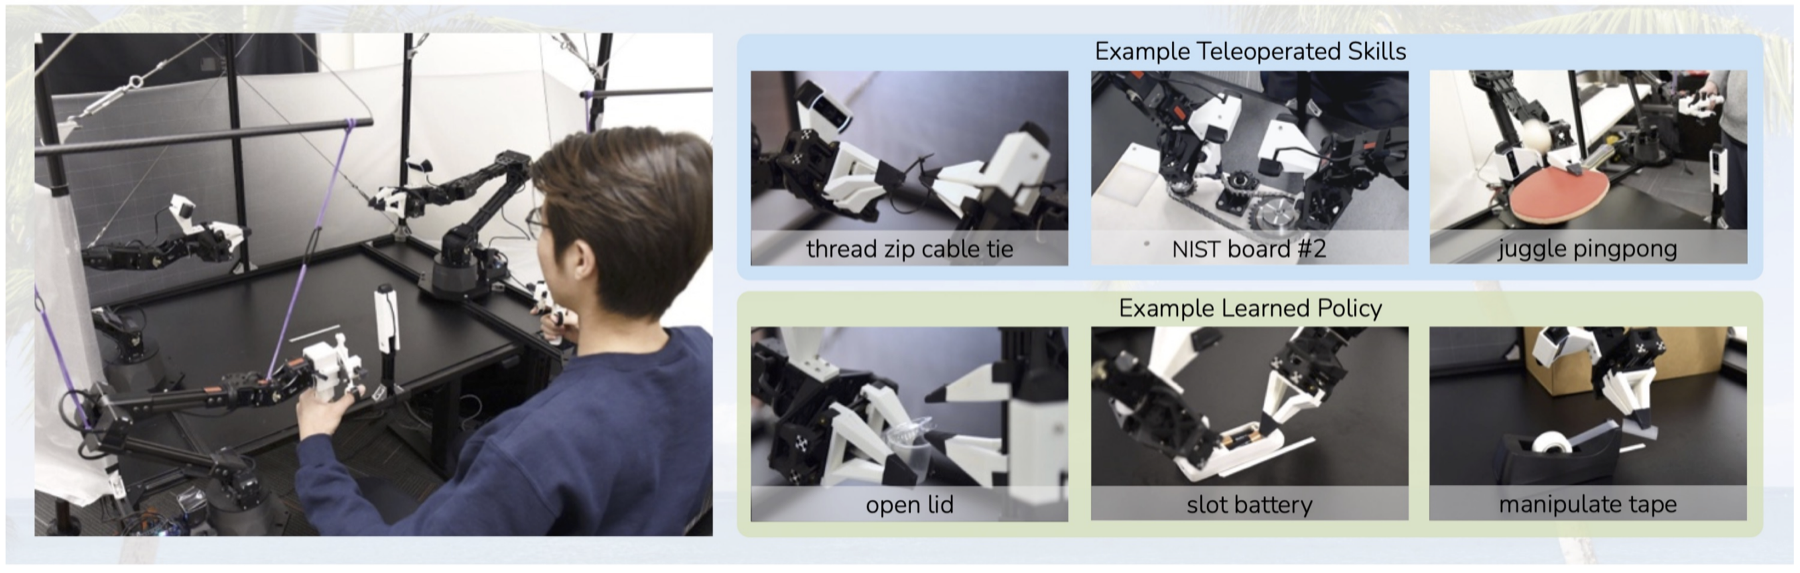
Fig. 1, Zhao et al., RSS 2023
이형민 · 서울과학기술대학교 전자공학과
양팔 로봇 시스템 전체
480×640 RGB, 유일한 센서
task당 시연 50개 (~10분 분량)
실세계 fine manipulation 성공률
학습된 정책의 실행 (Open Cup) · 공식 프로젝트 페이지 영상
Fine manipulation이라는 문제
mm급 공차 + 접촉 + 변형·반투명 물체. 오차 수 mm가 곧 실패.
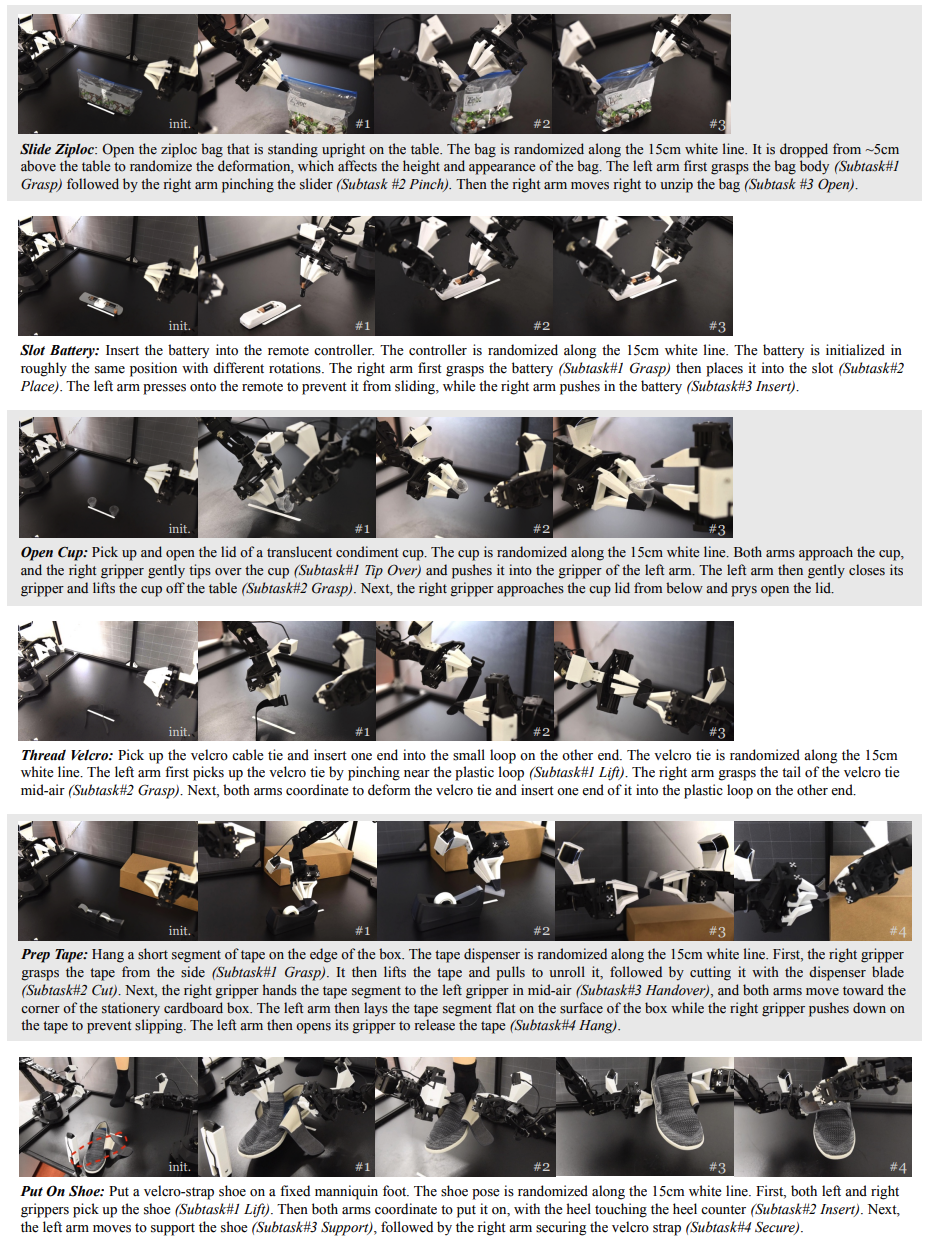
실세계 6 task · Fig. 6, Zhao et al. 2023
Ziploc 개봉 · 배터리 삽입 · 반투명 컵 뚜껑 열기 · 벨크로 타이 꿰기 · 테이프 절단-전달 · 신발 신기기. 전부 양팔 협응 + mm급 공차.
물체부터 인지에 적대적: 반투명 컵·테이프, 검정 배경 위 검정 케이블 타이(저대비), 형태가 변하는 변형체.
평가는 초기 배치를 랜덤하게 바꿔가며 (15cm 선 위 무작위) 물리 rollout, subtask 단계별 성공률로 보고.
만들어야 하는 것
웹캠 RGB 4장 + 현재 관절각
(관절각 표기 는 이 발표의 표기)
양팔의 절대 목표 관절각 (팔 6+그리퍼 1)×2 · 50Hz
인간 teleop demo 50개뿐. 순수 지도학습(BC), reward 없음
Task당 정책 1개 · 언어 지시 없음 · VLA 이전(2023-04) 시대의 single-task specialist.
고전 파이프라인: sense → plan → execute
2023년 이전, 이미지는 정책의 입력이 아니라 좌표를 재는 계측기였다.
지능은 "정확한 좌표 + 기하학적 계획"에 있고, 카메라의 일은 좌표를 재는 것으로 끝난다.
Task-specific함이 사는 곳
같은 파이프라인에 색을 칠해 보면, 전부 task마다 손으로 만든 것들이다.
Task가 바뀌면 붉은 것 전부를 엔지니어가 다시 설계한다. Task-specificity가 설계 공간에 산다.
오차 예산: 정밀도의 가격
최종 오차는 파이프라인 각 단의 오차 합. mm 공차를 맞추려면 항마다 장비가 필요하다.
DexPilot 류 teleop
(단팔 + hand)
Shadow Teleoperation System
(App. A 비용 지형)
ViperX (이 논문의 팔)의 accuracy
이 기준으로는 자격 미달
저가 로봇은 백래시·휨 때문에 자기 자신의 모델(FK)부터 부정확.
허용오차 mm의 작업을 5–8mm짜리 팔로 한다는 것 자체가 이 세계관에선 성립 불가.
돈으로 못 사는 항: M의 세계-절반
접촉·변형의 물리.
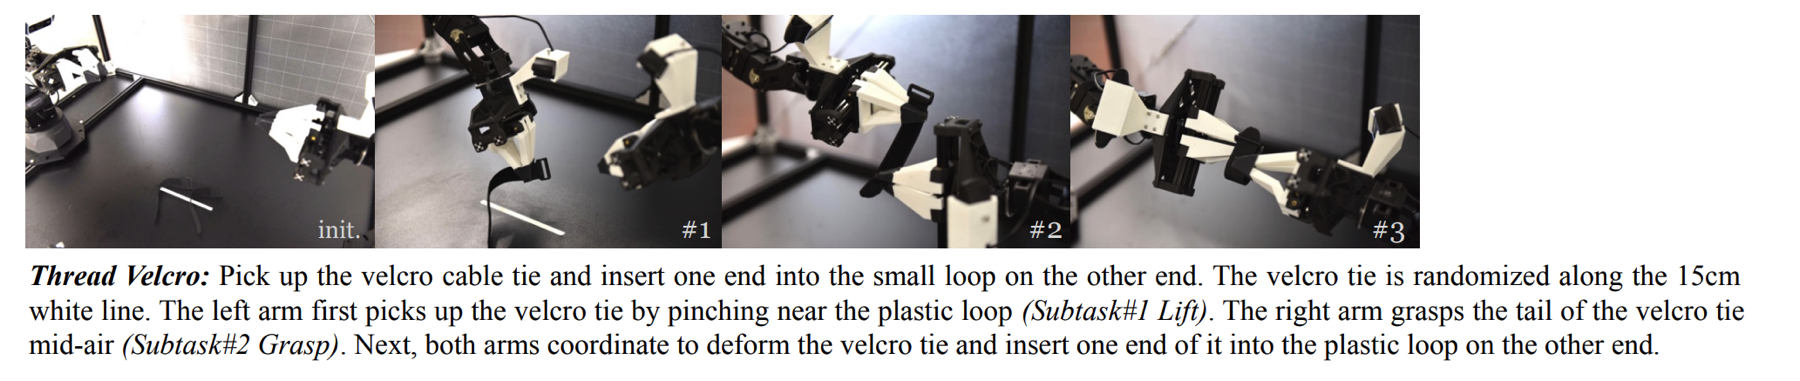
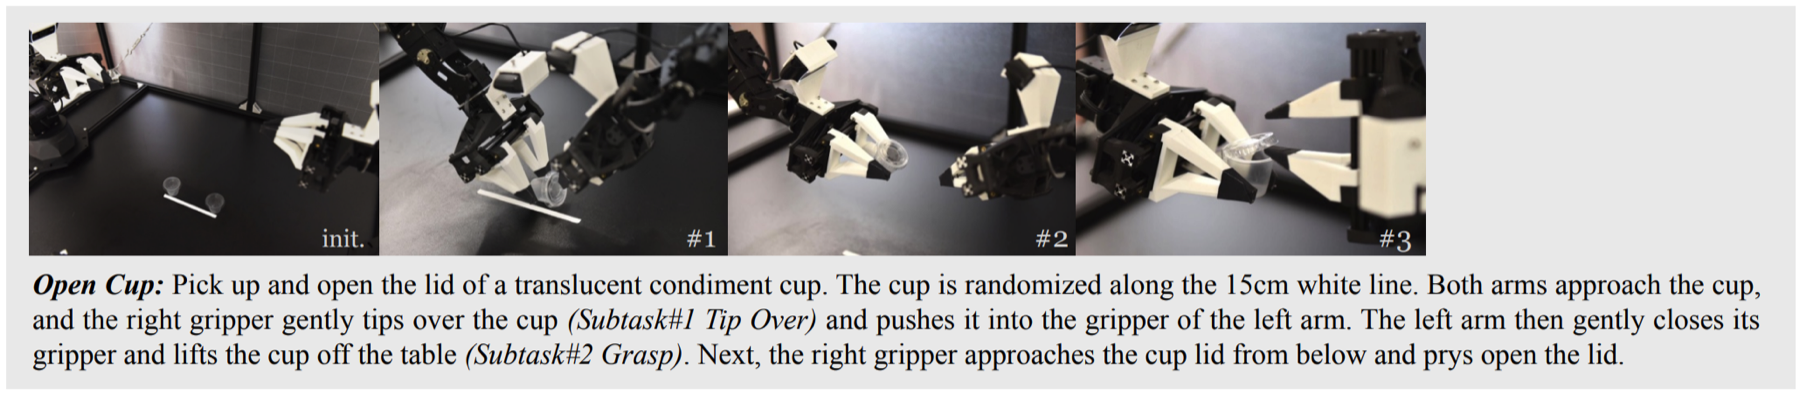
검정 배경 위 검정 케이블 타이 · 반투명 컵 · Fig. 6, Zhao et al. 2023
정의 불가: 휘는 타이, 구겨지는 봉투의 "pose"는 저차원 벡터로 존재하지 않음
붕괴: 반투명·저대비·접촉 순간의 가림. 재측정이 가장 필요한 순간에 가장 불가능
는 충실: 낡은 계획 를 정확하게 틀리게 추종한다
이 논문의 질문 (원문)
“Can learning enable low-cost and imprecise hardware to perform these fine manipulation tasks?”
단서는 인간. 인간의 고유수용감각도 산업 장비급 정밀도가 아니지만,
보면서 매 순간 보정하는 것으로 정밀 작업을 해낸다.
전환의 논리
두 가지 정확성 전략: 오차 제거 vs 오차 상쇄
오차 제거
기존 스택: 정확성을 실행 전에 확보
정밀 계측·캘리브레이션 =
정밀 물리 모델 =
정밀 하드웨어 = 의 플랜트
실행 중 수정은 재측정이 성공할 때만 가능. 접촉·가림 순간엔 불가
오차 상쇄
ALOHA/ACT: 오차를 허용하고 매 순간 보정
하드웨어는 부정확해도 됨 (5–8mm)
50Hz 픽셀 closed-loop이 매 스텝 오차를 보정
정확성의 원천: 실행 전 계측 → 실행 중의 시각 보정
보정 반응은 계산으로 만들지 않는다. 인간의 교정 반응이 담긴 demo에서 배운다. (→ 데이터 필요성 복선)
정책 = 무한히 싼 재계획
파이프라인의 앞 네 슬롯이 신경망 하나로 붕괴하고, c만 살아남는다.
재계획의 비용이 바뀜
5시간의 학습으로 미리 계산해 두고(상각), 실행 중엔 조회 10ms
재계획의 입력이 바뀜
좌표 재측정 (접촉 순간 불가) → 픽셀
후자가 없으면 "빠른 재계획"만으로는 접촉 순간에 여전히 죽는다. 학습이어야 했던 이유.
전환의 논리
Task-specificity의 이사: 설계 공간 → 데이터 공간
기존
task마다
재설계
엔지니어의 몇 주
ALOHA / ACT
task마다
demo 데이터셋만 교체, 레시피는 동일
오퍼레이터의 몇 분
CV에서 일어났던 전환과 구조가 같다: 손설계 feature (SIFT·HOG) + 기하 검증 → end-to-end CNN.
manipulation에서는 같은 전환이 약 10년 늦게 일어났다.
ALOHA: <$20k 양팔 teleoperation
기성품 팔 4대 + 3D 프린팅 부품 + 웹캠 4대. teleop·기록 모두 50Hz.
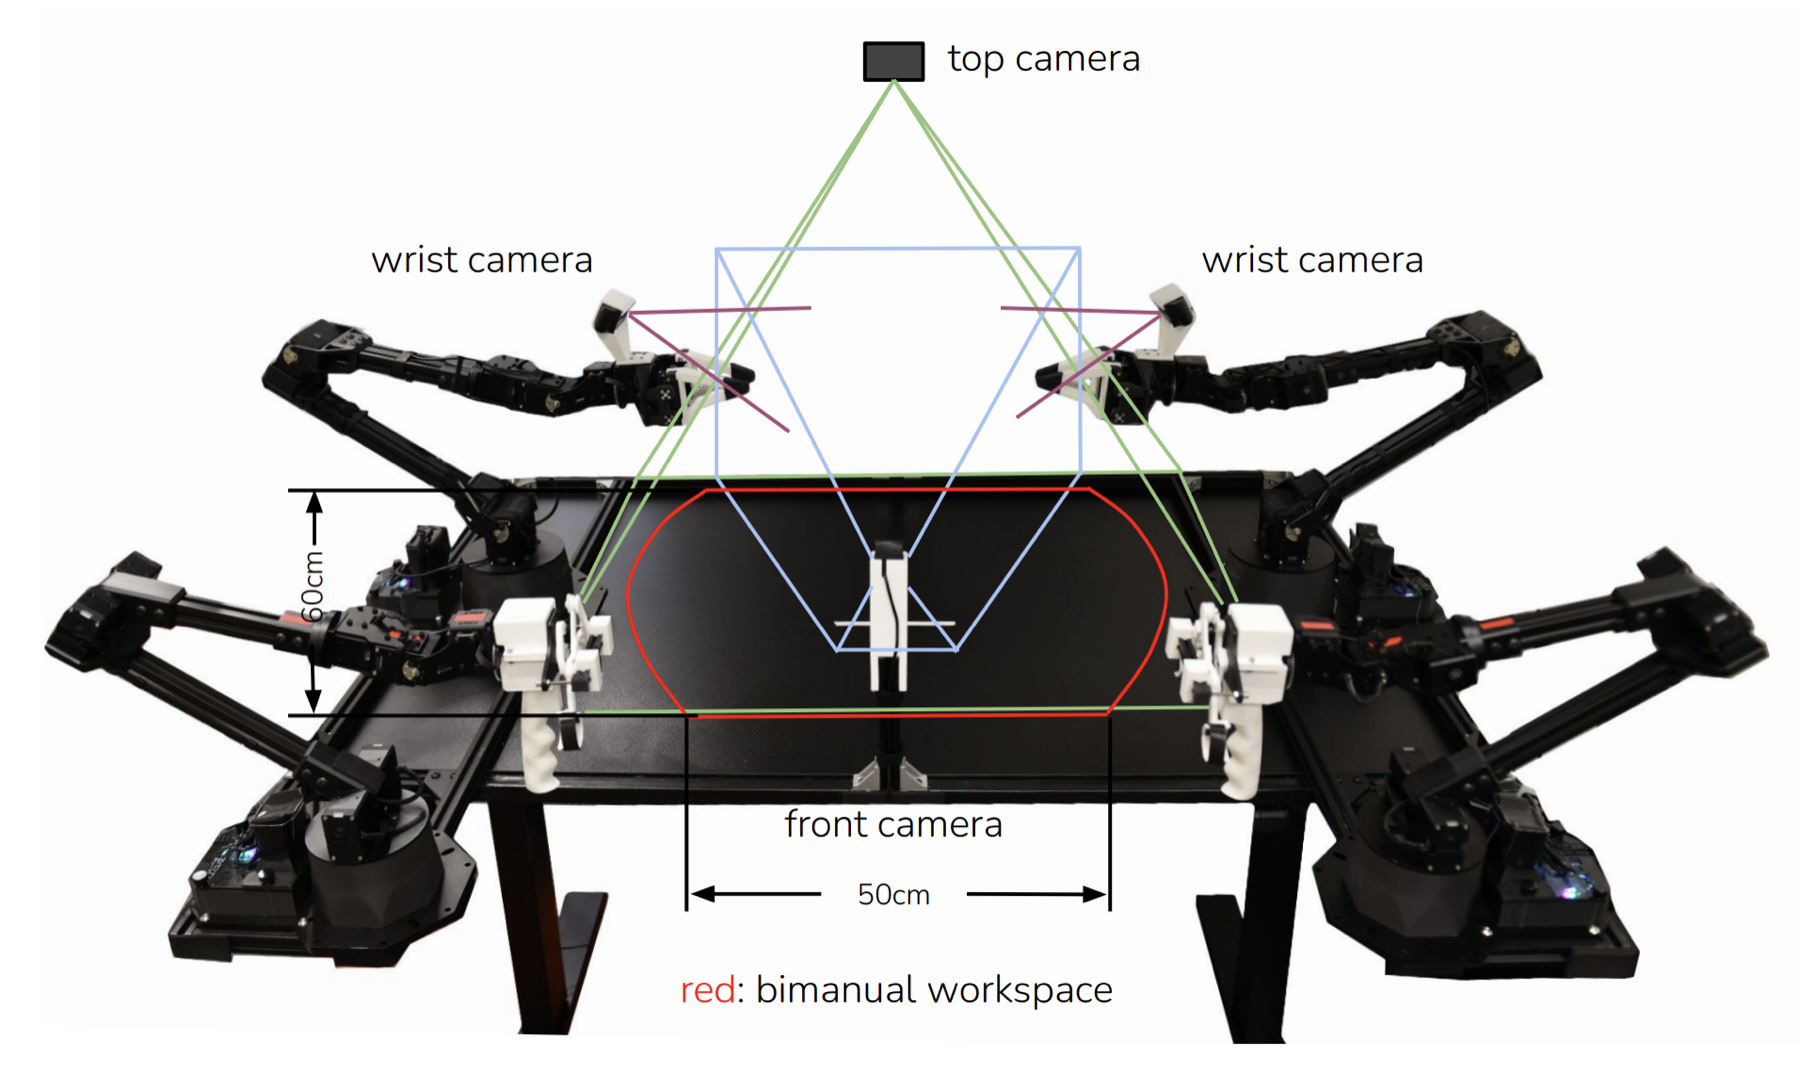
카메라 4대(손목 2 + 정면 + 상단)와 양팔 작업 공간 · Fig. 3, Zhao et al. 2023
Teleop 역량 몽타주 · 공식 프로젝트 페이지 영상
Joint-space mapping: 측정되는 것이 이미 답
사람이 leader 팔을 손으로 끌면, 그 관절각이 그대로 follower의 목표가 된다.
pose→관절각이라는 역문제가 표현조차 되지 않는다. 명령 공간이 곧 실행 가능 공간.
제안 ① ALOHA
인간 지능을 로봇의 몸에
빙의시키는 장치
※ 우리의 정식화. 논문의 "kinesthetic similarity" (App. A)를 밀고 나간 것
Open Cup: tip over → nudge → 양팔 들기 → 손끝으로 비집기 · Fig. 6, Zhao et al. 2023
이 시퀀스는 인간 맨손의 전략이 아니다. 그리퍼 두 개라는 몸의 제약 안에서 인간이 찾아낸
로봇-네이티브 해법.
demo에 기록되는 것은 번역본이 아니라 원본이다.
aₜ의 정체: 위치 명령에 인코딩된 힘
action = leader의 절대 관절각. follower가 아니라 leader인 것이 핵심.
(개념적 표기. 모터 내장 PID의 비례항)
사람이 누르는 동안 leader는 follower보다 "더 안쪽"에 있다. 그 차이가 힘. force 센서 없이 접촉 작업이 되는 열쇠.
“the amount of force applied is implicitly defined by the difference between them, through the low-level PID controller” (§IV)
그래서 절대 목표여야 한다. delta로는 힘도, 자기 보정 앵커도 잃는다 (논문: delta 사용 시 성능 저하).
정책의 눈: 카메라 4대
손목 2 + 정면 + 상단, 480×640 RGB. 정책이 받는 시각 입력의 전부.
4캠 관측 (Open Cup) · 공식 프로젝트 페이지 영상
손목 캠 + 파지부를 가리지 않는 개방형(see-through) finger로 접촉 지점이 시야에 담긴다.
Naive BC의 붕괴: compounding error
훈련은 i.i.d. 지도학습, 배포는 closed-loop. 내 오차가 내 입력을 오염시킨다.
단발 BC의 성능 저하 (Ross & Bagnell)
제곱의 근원: 초반 실수의 비용이 에피소드 잔여 길이에 비례. 한 번 튜브를 벗어나면 회복 demo가 없다.
fine manipulation은 최악 조합: 좁은 튜브(mm) × 긴 horizon ( = 400–700) × 회복 demo 부재.
제안 ② ACT · Action Chunking
400–700 스텝의 task
→ 4–7수의 문제
“k-fold reduction in the effective horizon”. 행동 하나가 아니라 덩어리(chunk)를 예측.
Chunking이 자르는 것 세 가지
결정을 덜 자주, 한 번에 크게.
오차가 복리로 불어나는 순간 = 오염됐을 수 있는 관측에 다시 조건화하는 순간. 그 횟수 자체를 1/k로.
지능의 오염 → 근육의 처리
chunk 실행 중 2mm 밀림은 정책의 입력이 아니라 PID의 오차항이 된다. 절대 목표가 자기 보정 앵커.
갈림길의 우유부단 차단
매 스텝 갈림길 투표(왼쪽·오른쪽 널뛰기) 대신 2초짜리 하나의 정합적 계속에 커밋. 둘 다 유효할 땐 하나를 밀고 나가는 것 자체가 가치.
덤: demo 속 멈칫거림(pause)도 "얼마나 멈추는지"가 chunk 안에 기록되어 흡수. history 조건화 없이 (causal confusion 회피).
레일과 스프링: 실행의 2중 루프
고전 파이프라인에서 살아남았던 c가 정확히 여기서 일한다.
학습의 경계선은 픽셀 → setpoint까지. 그 아래 kHz 안정화는 고전 제어가 공짜로. task 지식은 데이터로, 안정화는 펌웨어로.
남은 문제: 같은 관측, 다른 궤적
같은 관측에서도 사람은 다른 궤적을 쓴다. 한 사람이 모아도 본질적으로 stochastic (§V-B).
다봉(multimodal) 분포 위의 deterministic 회귀는 모드들의 평균으로 붕괴. 어느 demo도 하지 않은 무효 action.
제안 ② ACT · CVAE
교집합은 에서,
그때그때의 다름은 에서
encoder: 정답 chunk를 보고 "이번 실행의 방식"을 로 압축. 이미지는 안 받음, 관절각 만 (논문 표기 ) · 학습 후 폐기
decoder = 정책 그 자체: 관측 전체 + 방식 힌트로 chunk 복원
L1 재구성 + KL 정칙화 ()
= 관측을 고정해도 남는, 이번 실행의 선택. 이것을 격리하면 조건부 회귀는 다시 well-posed.
제안 ② ACT · CVAE
: 평균이 안전해지는 공간에서의 평균
※ 우리의 프레임. CVAE-for-structured-prediction (Sohn et al., 논문 인용 [55]) 전통의 표준 관행
action 공간의 평균 = 모드 혼합 (정면 충돌) ✗
방식 공간의 중심 = 전형적 방식 하나의 정합적 실행 ✓
CVAE가 한 일: 평균 내면 안 되는 공간(action)의 다봉성을 평균 내도 되는 공간()으로 옮겨 놓은 것. 배포는 deterministic. 스타일 일관성은 덤.
제안 ② ACT · CVAE
분리의 근거: KL이 만드는 정보 병목
※ 우리의 프레임. 논문이 인용한 β-VAE·information bottleneck 관점의 연장
로 예측 가능한 정보는 에서 밀려난다
(같은 reconstruction 이득을 페널티 없는 경로가 주므로)
예측 불가능한 모드 선택·스타일만 에 남는다
(그것만이 페널티를 감수할 만큼 reconstruction을 줄여줌)
학습 시 정답이 를 거쳐 들어가도 정책이 를 무시하는 퇴화가 안 일어나는 이유: 그 채널의 용량이 KL로 조여져 있다.
Temporal Ensemble ≠ smoothing
chunking이 앗아간 반응성·부드러움을 갚는 장치. 매 스텝 query하고, 같은 시점을 겨냥한 예측들만 섞는다.
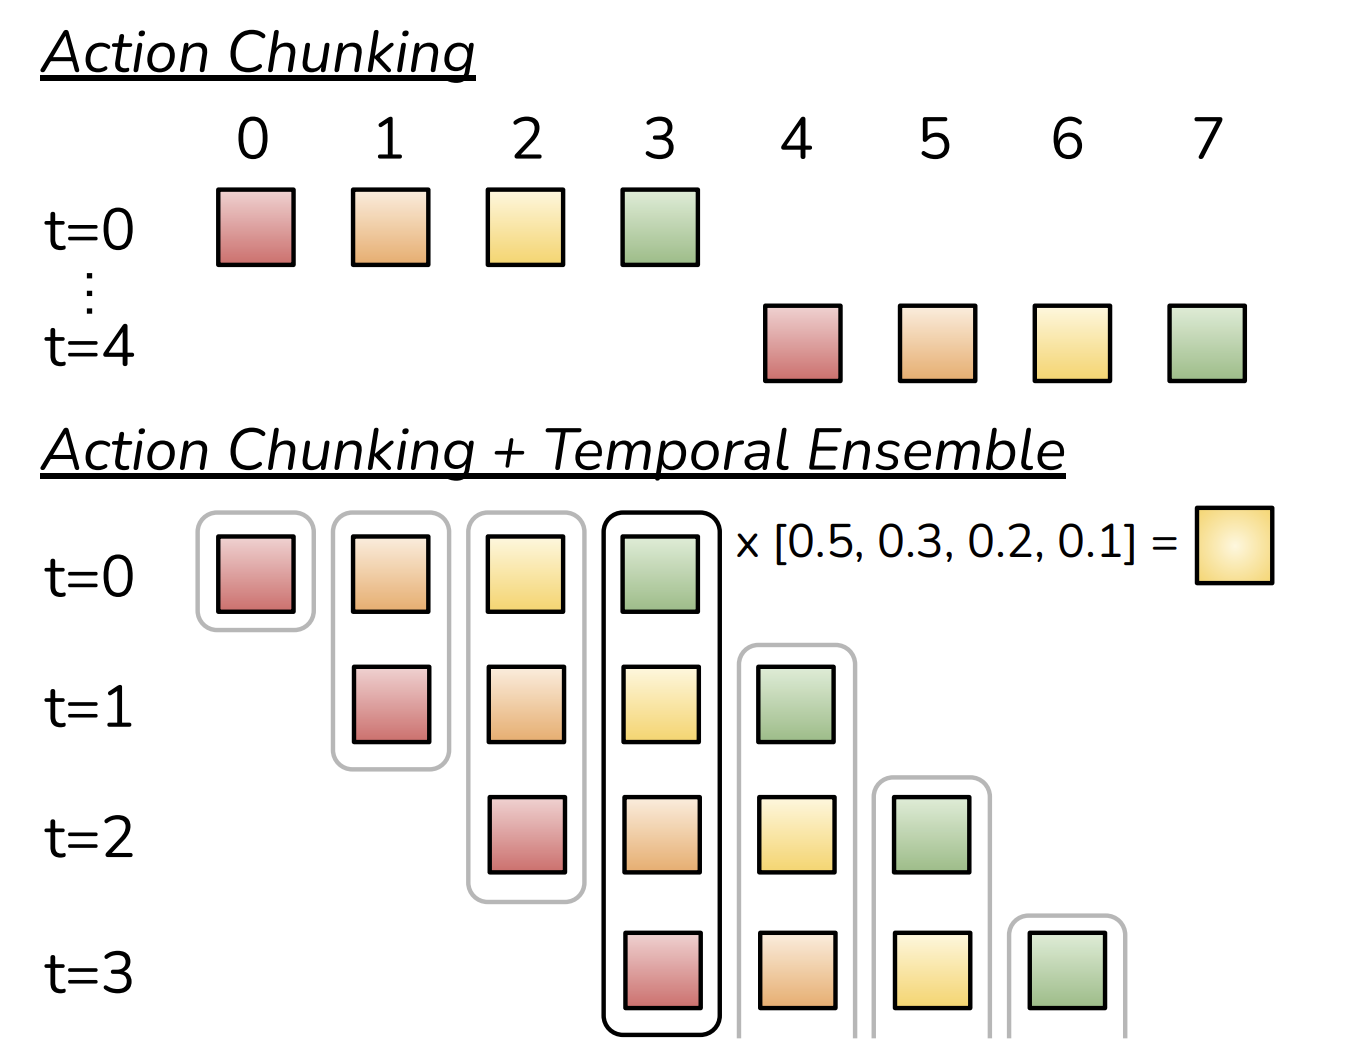
Fig. 5, Zhao et al. 2023
= 가장 오래된 예측이 최대 가중 (커밋 우선) · 구현 기본값
인접 시점의 action을 섞으면 서로 다른 의도의 혼합 = bias (일반 smoothing).
TE는 같은 timestep 를 겨냥한 예측들의 앙상블.
의도 혼합이 없다 (§IV-A).
효과: chunk 경계의 점프 소멸 + 새 관측이 매 스텝 (낮은 가중으로) 반영. 추가 학습 비용 0.
"DETR for action chunks"
아키텍처는 의도적으로 지루하다. 지적 내용은 chunking · CVAE · TE에 있다.
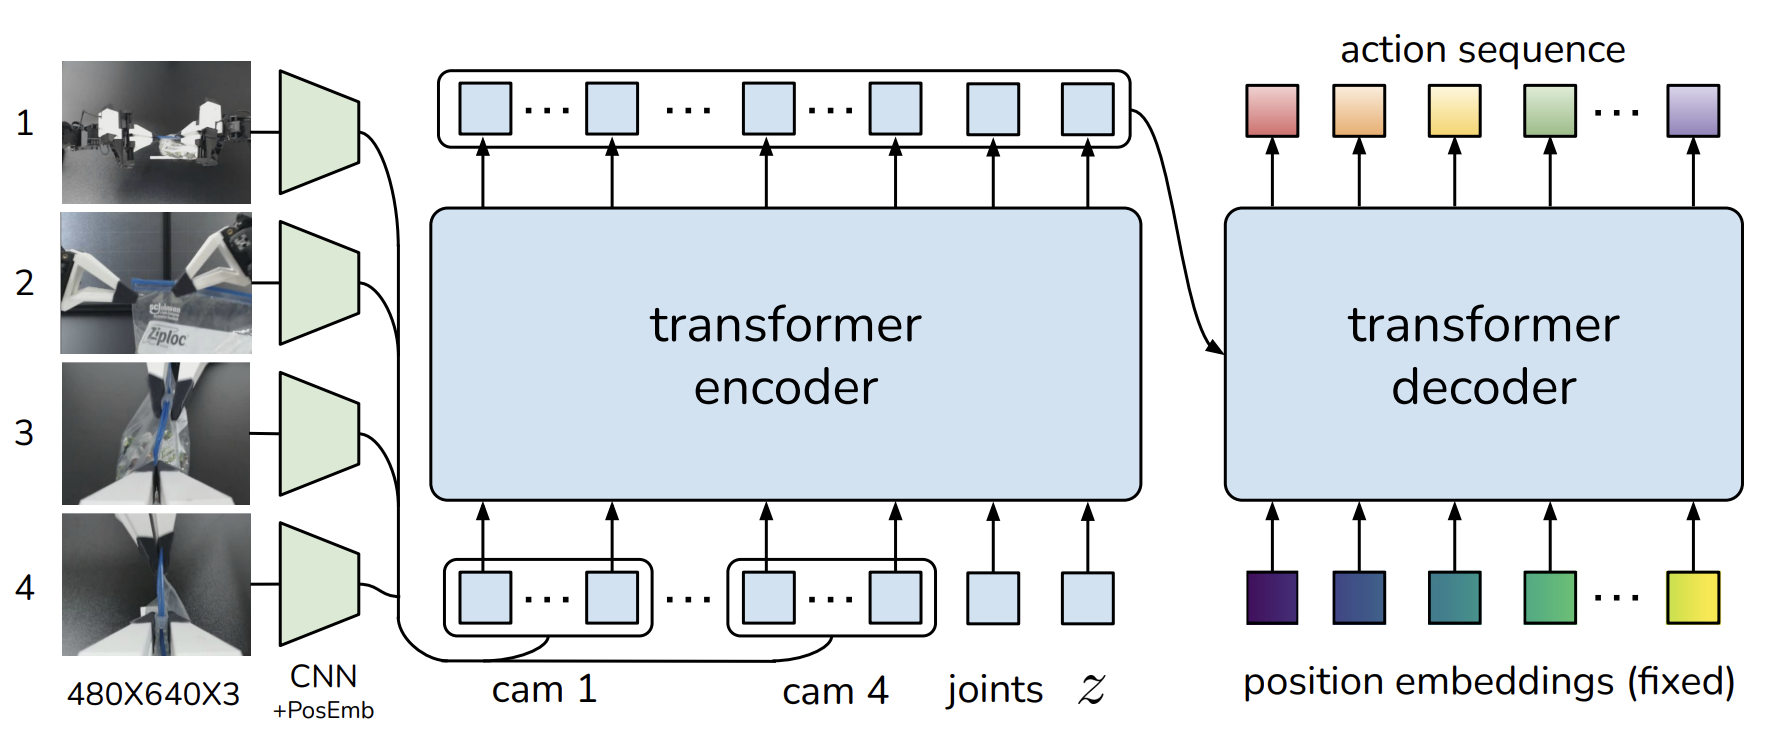
Fig. 4 (decoder), Zhao et al. 2023 · 공식 구현도 DETR 코드베이스 기반
Non-autoregressive: chunk 100스텝을 병렬 한 번에
→ inference 0.01s의 비결
ResNet18 ×4캠 + transformer enc-dec
~80M params · 공간 토큰 보존 (카메라당 300개)
task당 scratch ~5h
RTX 2080 Ti 1장 · 컴퓨트까지 low-cost
결과 ①: 시뮬 2 + 실세계 2 (Table I)
시뮬 항목은 [scripted | human] 병기. baseline: BC-ConvMLP · BeT · RT-1 · VINN, 전부 chunking 없음.
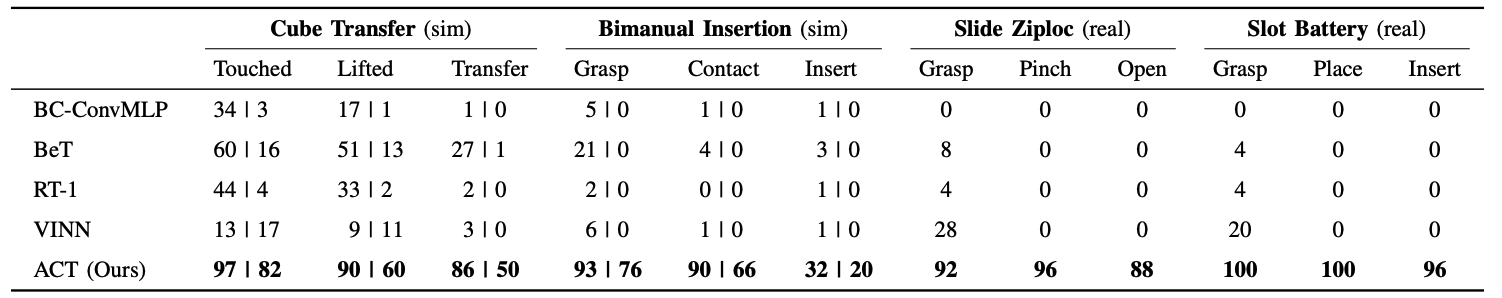
Table I, Zhao et al. 2023 (subtask 단계별 성공률 %)
단계별 붕괴 서명: baseline은 첫 단계는 곧잘 하다 최종 ~0%. compounding의 지문.
scripted → human 갭: 전 방법 하락 (ACT도 86→50). human demo의 stochasticity가 실재한다는 정량 증거.
실세계: Slide Ziploc 88% · Slot Battery 96% (baseline 최종 0%).
결과 ②: 실세계 나머지 4 task (Table II)
vs BeT (그때까지 최고 baseline).
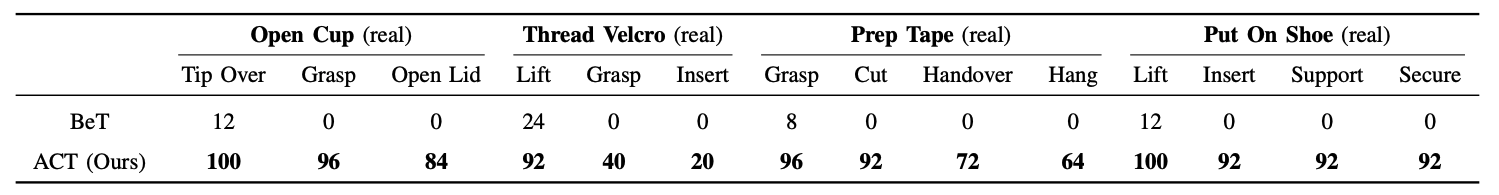
Table II, Zhao et al. 2023 · ACT 최종: Open Cup 84 · Thread Velcro 20 · Prep Tape 64 · Put On Shoe 92
정직한 실패, Thread Velcro 92 → 40 → 20:
검정 배경 위 검정 타이(저대비) + 화면 속 소면적.
"가 task의 본질을 담지 못하면 배울 수 없다"는 관측성 한계의 실증.
계보: 이 논문 이후
action chunking은 이후 VLA의 default가 된다.
저자들이 그 계보의 주역: Finn·Levine이 Physical Intelligence 공동창업, Zhao도 저자로.
· GR00T · OpenVLA-OFT, 전부 action chunk를 출력한다. 그 "왜"가 이 논문.
Thank you
paper: arXiv 2304.13705 · project: tonyzhaozh.github.io/aloha · code: github.com/tonyzhaozh/act
Backup
Q&A 방어용 상세 슬라이드
IK의 곤란 3종과 물리 기구에서의 소멸
도달 불가 pose (workspace·joint limit 밖). VR 조종자는 허공에서 이를 느낄 수 없다. leader는 물리적으로 안 가진다.
6-DoF는 비선형이라 같은 pose에 유한 개(전형적으로 ≤8)의 이산 해. 팔꿈치 위/아래 등. 잘못 고르면 팔이 홱 뒤집힌다. 물리 기구는 연속으로만 진화하므로 branch "선택"이라는 문제 자체가 소멸.
Jacobian이 rank를 잃는 자세 근방. 올바른 branch조차 관절 속도 폭주를 요구한다. 병은 solver가 아니라 명령(pose 경로)에 있다. 물리 팔은 singular 자세를 그냥 통과한다.
6관절 = pose 6 자유도를 정확히 커버하는 최소 구성. 여분 관절(7-DoF)은 IK가 막혔을 때의 우회로인데, ALOHA는 IK 자체를 없앴으므로 그 대가(Panda급 가격, 저가 모터의 백래시 누적)를 치를 이유가 없었다.
고전 스택의 정확한 자료형: FSM (hybrid automaton)
국면별: 참조 궤적 조각 · 제어기 설정 · 전환 술어 ("force > 2N이면 다음 국면")
ACT에는 명시적 가 없다. "지금 어느 국면인가"는 관측→행동 매핑에 암묵 흡수.
FSM은 정책에서 사라지고 평가 루브릭(subtask 단계)으로만 생존.
TE의 캐비앗: staleness, 그리고 CVAE와의 맞물림
Staleness lag은 남는다. 무bias가 지우는 것은 의도-혼합 bias뿐. chunk 실행 중 세계가 변하면 낡은 관측 기반 예측이 (최대 가중으로) 평균을 지배한다. 반응 지연은 으로 조절되는 trade-off로 잔존.
TE의 안전 전제 = 예측들이 같은 모드의 섭동일 것. ACT에선 deterministic이 이를 보장한다는 해석. CVAE와 TE가 맞물려 있다 (논문 미명시).
VINN에는 TE가 해롭다 (−20%, §VI-A). GT action 검색이라 모델링 오차가 없고(앙상블 이득 0), 인접 검색이 서로 다른 demo(=다른 모드)에 꽂혀 action 공간 모드 혼합이 재발. 저자 가설 그대로.
초기 배치 변동(ρ₀)의 일반화: 두 방식
배터리가 어디 놓이든 같은 Plan 함수에 새 가 들어가 기하학적으로 재계산. 기하가 공짜로 일반화한다. 단, 전부 "가 맞고 이 맞다"에 조건부.
demo가 15cm 랜덤 배치 선을 덮어야 하고, 신경망이 그 사이를 보간. 그래서 demo 수집 시 초기 배치를 일부러 randomize한다. 데이터가 를 span해야 학습·평가가 성립.